Prase difference in latest Nginx
Parse difference in latest Nginx
首先感谢[@Nick](Home | Nick’s Blog)师傅,在发现Nginx最新版本的新玩法后第一时间分享给我
在Nginx 1.31.5更新了什么
参考https://blog.nginx.org/blog/nginx-routing-on-http-request-body
为了兼容现代上层协议,Nginx新增了client_body_early_read指令先读取请求正文进行处理
同时还增加了js_set用于解析JSON用于适应上层协议例如MCP、JSONRPC
为什么要做此改变呢?
因为在这些上层协议中,需要用到URI的数量几乎没有,例如mcp通常只使用/mcp一个接口
而对方法的调用全部都已经被封装到JSON的内部了
例如
{
    "method": "initialize",
    "params": {
        "protocolVersion": "2025-11-25",
        "capabilities": {
            "sampling": { },
            "elicitation": {
                "form": { },
                "url": { }
            }
        },
        "clientInfo": {
            "name": "pi-mcp-yakit",
            "version": "1.0.0"
        }
    },
    "jsonrpc": "2.0",
    "id": 0
}
那么如何要拦截外部对某方法的未授权调用,就需要Nginx先对JSON进行解析从而拦截流量
在http{}或server{}启用后就可以指示 NGINX 在 location 选择之前就先读取请求正文。
server {
    listen 8000;
    client_body_early_read 1;
    location /test_body {
        if ($request_body = "BAD_DATA") { return 403 "Bad data\n"; }
        return 200 "OK\n";
    }
}
JSON Parser in Nginx
dump了份源码下来,先简单审计一下
调用逻辑
对JSON主要的解析逻辑应该是在src/core/ngx_json_parse.c这里还是不得不吐槽这种大一点的项目的c读起来真的太吧唧累了
Nginx对JSON的解析逻辑和java这些不太一样,java对json是当作对象来进行还原
而Nginx则采用的是SAX风格的解析,逐字节处理,每遇到token就进行回调
在头文件里预定义了33个状态用来判断JSON处理机当前的状态
typedef enum {
    ngx_json_start = 0,
    ngx_json_done,
    ngx_json_object,
    ngx_json_object_next,
    ngx_json_object_name_separator,
    ngx_json_value,
    ngx_json_object_value_separator,
    ngx_json_array_value_separator,
    ngx_json_array,
    ngx_json_string,
    ngx_json_number_minus,
    ngx_json_number_int,
    ngx_json_number_int_zero,
    ngx_json_number_frac,
    ngx_json_number_frac_digit,
    ngx_json_number_exp,
    ngx_json_number_exp_plusminus,
    ngx_json_number_exp_digit,
    ngx_json_escaped,
    ngx_json_escaped_hex,       /* first \uXXXX: reading the four hex digits */
    ngx_json_surrogate_start,   /* expect '\' beginning the low surrogate */
    ngx_json_surrogate_u,       /* expect 'u' of the low surrogate */
    ngx_json_surrogate_hex,     /* low \uXXXX: reading the four hex digits */
    ngx_json_true_t,
    ngx_json_true_tr,
    ngx_json_true_tru,
    ngx_json_false_f,
    ngx_json_false_fa,
    ngx_json_false_fal,
    ngx_json_false_fals,
    ngx_json_null_n,
    ngx_json_null_nu,
    ngx_json_null_nul
} ngx_json_state_e;
对外的入口只有
void      ngx_json_ctx_init(ngx_json_ctx_t *ctx, ngx_pool_t *pool);
ngx_int_t ngx_json_parse_ctx(ngx_json_ctx_t *ctx, u_char *data, size_t len);   /* 增量式 */
ngx_int_t ngx_json_parse(ngx_pool_t *pool, ngx_str_t *json,
                         ngx_json_handler_pt handler, void *data);            /* 一次性 */
三个函数
而ngx_json_prase本质也是对ngx_json_parse_ctx的调用
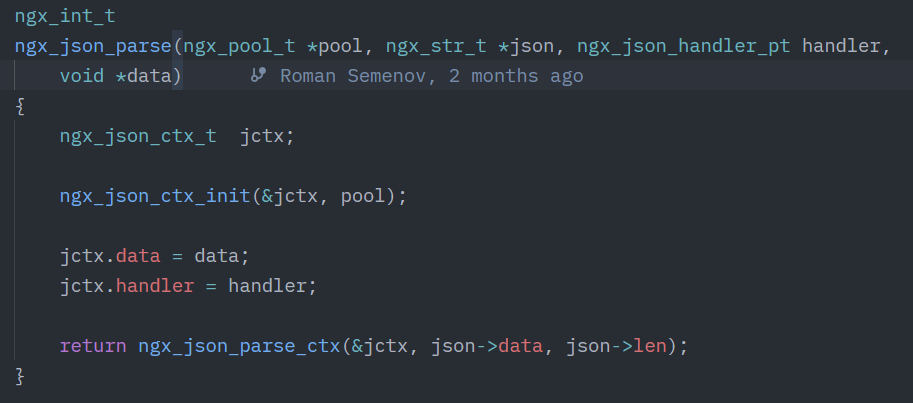
那么就很明确了,要重点关注的就是ngx_json_parse_ctx
整个函数用switch-case对当前的解析状态进行判断、
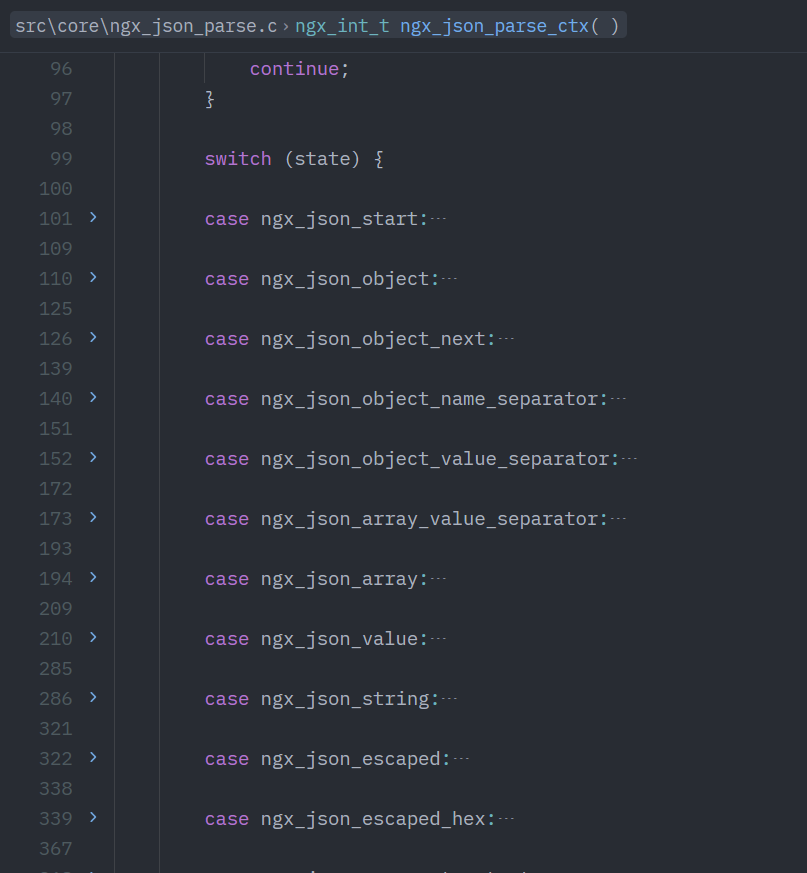
ngx_json_parse_ctx() 可以分块重复调用。每次返回前会把 ctx->state 存回上下文,所以同一份数据可以拆成多个 buffer 喂进去
直到出现错误返回错误信号,正常解析完毕最终进入ngx_json_done接着返回NGX_OK
那么谁调用了ngx_json_parse_ctx()呢?在src/http/modules/ngx_http_json_module.c中
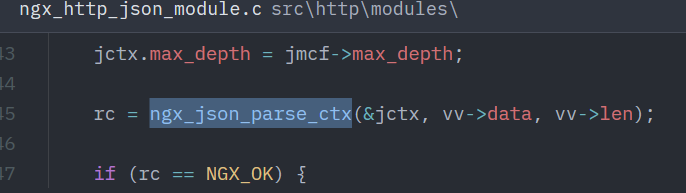
这样上下就已经串起来了,接着看一眼解析的逻辑
解析逻辑
主要要关注的其实就是一些特殊字符的解析,比如unicode
还有是否能通过撑爆一些阈值来达到绕过的效果
先找unicode的处理逻辑吧
前面我们已经知道了这个praser是逐个字符解析的,那么如果要解析键值对中的/uxxxx,必然先经过case ngx_json_string这个分支
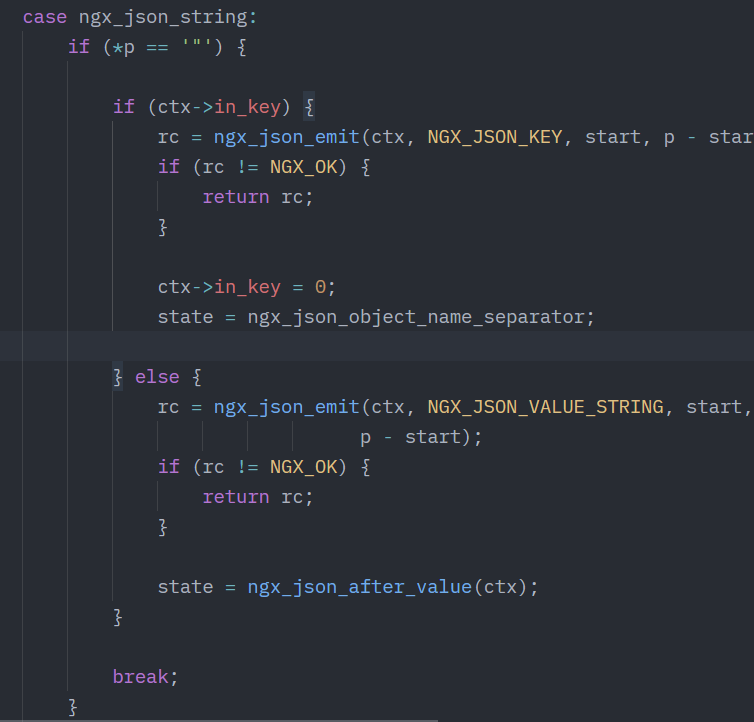
我们看到这里调用了 ngx_json_emit
跟进一下,发现这个函数是根据传入的event对应进行处理
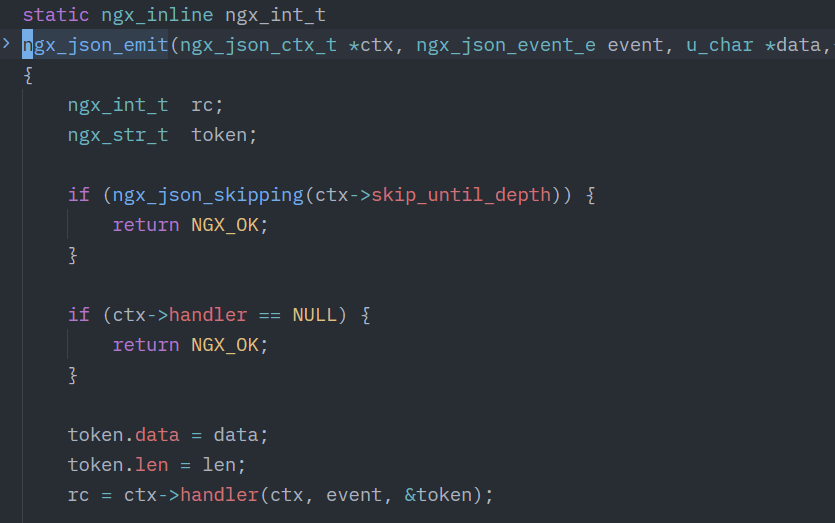
这里把ctx->handler赋值给了rc,接着做switch-case
那么看来这里是调用了一个函数,我们看回到上文,handler是ngx_http_json_handler,这个函数也是根据event处理的
继续跟进
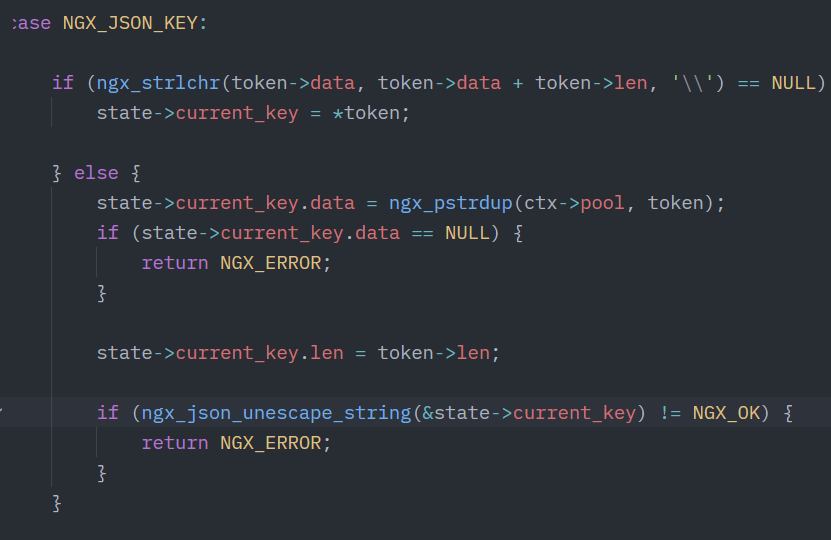
发现果然有unescape的处理逻辑,这里处理了键中的unicode
那么值呢?继续往下翻翻
发现这里逻辑相似
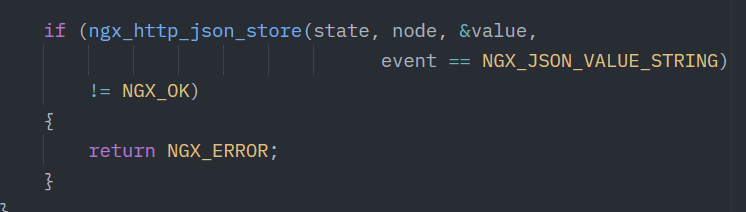
转到实现
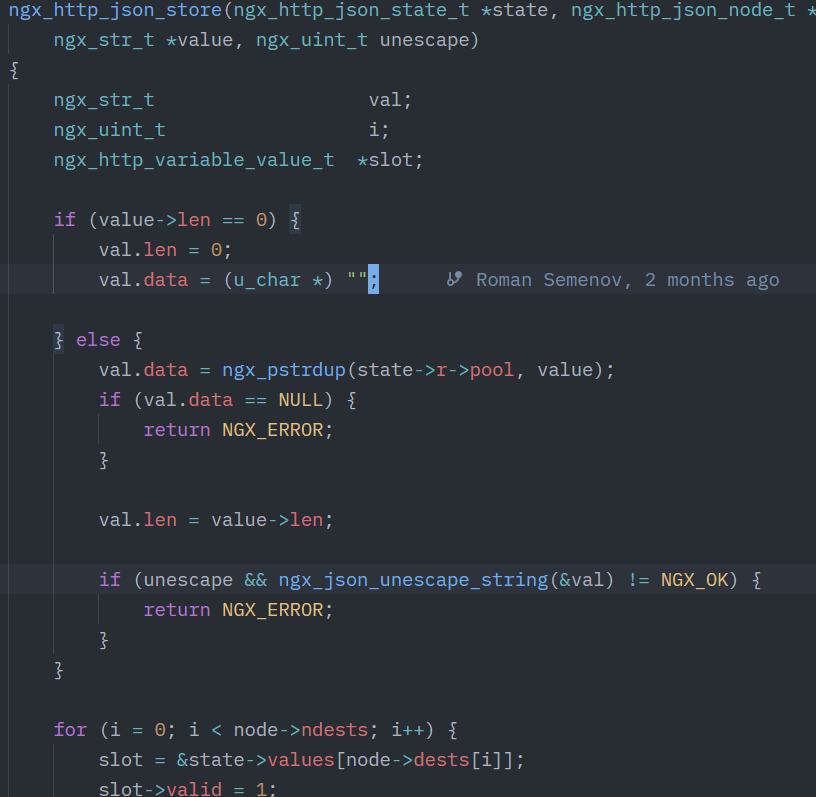
发现这里也确实对值做了unescape的处理
那么就返回去找NGX_JSON_KEY和NGX_JSON_VALUE_STRING:两个event
发现就是case ngx_json_string
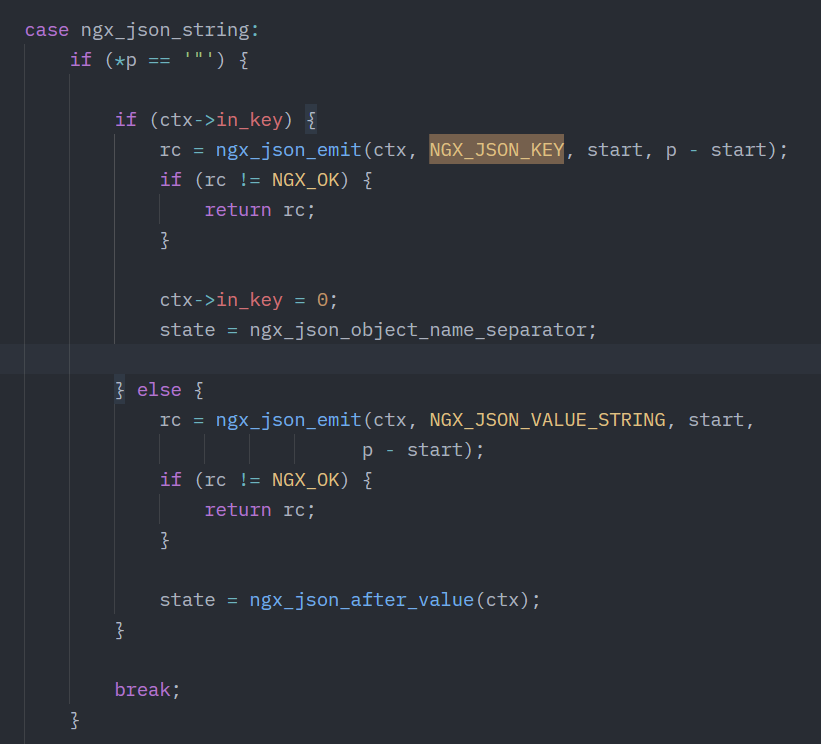
那么就都没问题了,接着看看解析的函数ngx_json_unescape_string
这里也是switch-case的处理
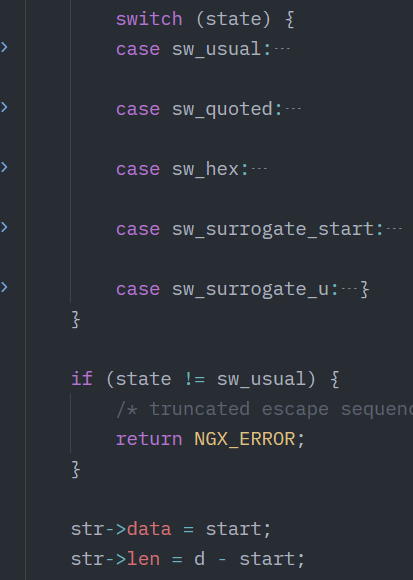
这里负责对unicode进行转义
乍一看也没什么问题,就是正常的解析过程,对unicode进行解码
但是如果是逐字符解析,在取内部其他对象的值时是否会解析呢?
例如传入{"a":{"b":"1","role":"\u0061dmin"}},我们只取a的键值去做正则的匹配
这是第一个问题
那么我们继续看最大嵌套深度的影响
ngx_http_json_module.c里面规定 NGX_HTTP_JSON_DEFAULT_MAX_DEPTH = 32
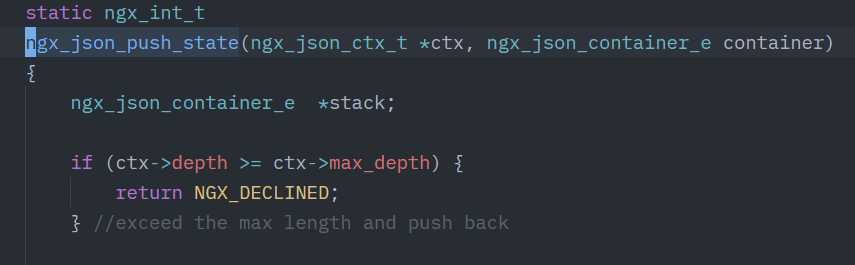
如果超过则会返回NGX_DECLINED
而后续的处理也很神秘
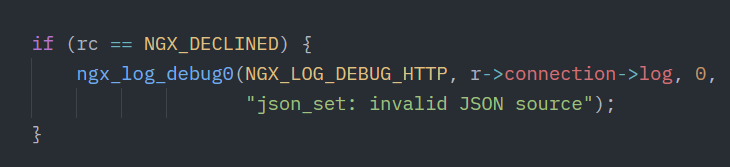
没有抛出错误,而是reset变量、写日志然后returnNGX_OK
那么我们其实很好使用的黑名单,我们就很好去进行绕过了,整个我们后面再说,这个是问题之二
此时看起来没有其他问题了啊,扔个AI复核了一遍,发现了新问题
Prase Difference between Nginx and backend
前面我们把思路限制在了JSON本身,而没有关注能不能塞入一些Nginx不能解析、后端自动trim的垃圾字符
那这种字符存在吗?
\xef\xbb\xbf并且我们知道这个NGX_DECLINED是一个只会被记录、不会被处理的错误,那么只要保证后端的解析正确,就可以任意构造非法的json绕过Nginx了
UTF-8 BOM
先看python的处理
#encoding=utf-8
import json

byte=b'\xef\xbb\xbf{"user":{"role":"admin"}}'
json=json.loads(byte)
print(json['user']['role'])
发现正常的解析出admin了

那么Nginx能否处理呢?答案肯定是不能的
ngx_json_parse_ctx中ctx默认是以ngx_json_start状态开始,接着就转到ngx_json_value
在分支ngx_json_value下
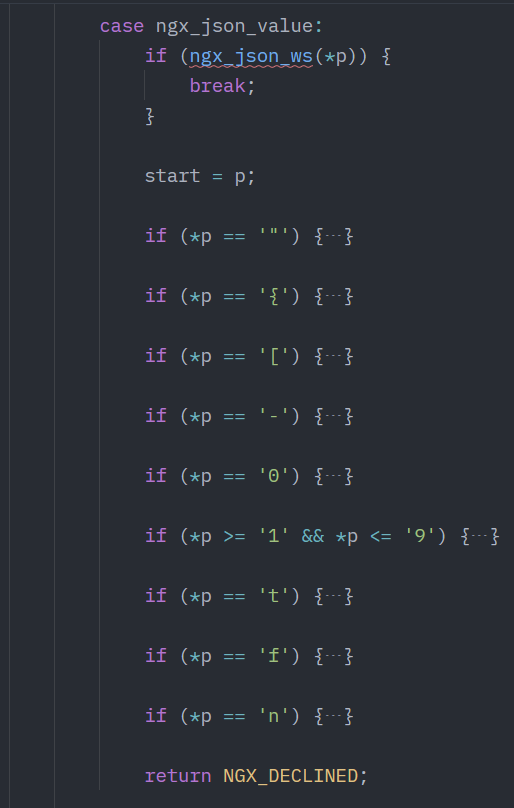
我们发现,并没有对UTF-8 BOM的处理
那么就会直接reset整个json,从而绕过黑名单
Depth Overflow
也就是我们之前说的第二个问题
构造一个恶意的嵌套键值对,只要深度超过32/指定的层数
当检测到深度过深时,就会自动抛出NGX_DECLINED
从而实现绕过
Lazy decode
也就是我们说的第一个问题
在json_set中
它不会对当前未定义的键进行取值解析
也就是说,假设配置中写
json_set $m $request_body "params"并用拿到的$m去做正则,假设对结果为1且不为受信任ip的请求进行拦截
map $m $is_admin {
    ~^admin$  1;
    default   0;
}
此时传入
{"params":{"method":"get","role":"\u0061dmin"}}取到的$m中的内容是{"method":"get","role":"\u0061dmin"}还是{"method":"get","role":"admin"}
运行结果是前者
如果Nginx想要对\u开头的unicode进行解码,就必须要调用ngx_json_unescape_string函数,在ngx_json_parse_ctx中只负责校验unicode的合法性而不进行任何解码
ngx_json_unescape_string函数的调用只有三个地方
ngx_http_json_insert_path ngx_http_json_handler ngx_http_json_store
分别在ngx_http_json_set、ngx_http_json_variable得到调用
其中ngx_http_json_store的调用实际都内置在ngx_http_json_handler中
而我们跟进其对a键所应值的处理流程
发现简单的来看事件流就是这样的:
NGX_JSON_OBJECT_OPEN->NGX_JSON_OBJECT_CLOSE
而中间的"method":"get","role":"\u0061dmin"都被正常prase/检验,不进行解码,并不执行lookup_key(如果取的值没有{}就会直接进入NGX_JSON_VALUE_STRING事件)
最后强行执行了
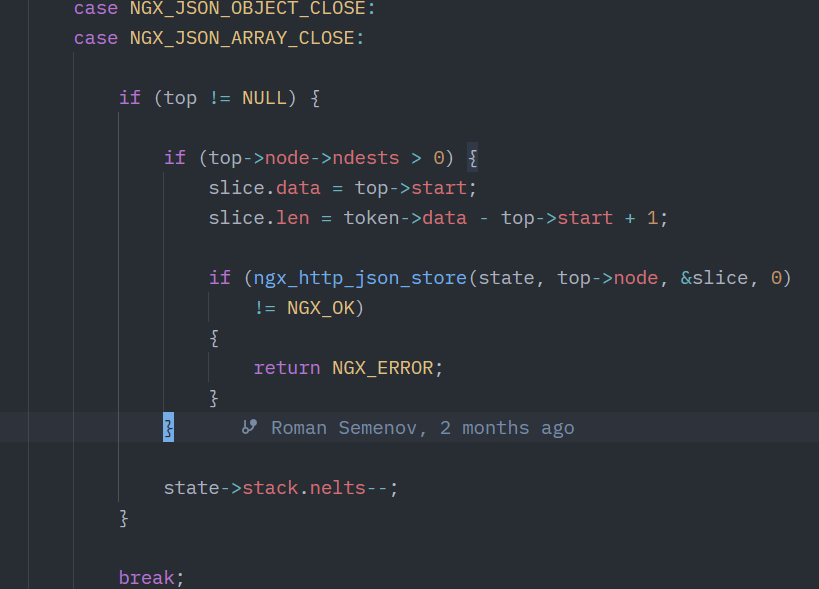
unescape参数传入为0 ,这里的if直接被短路
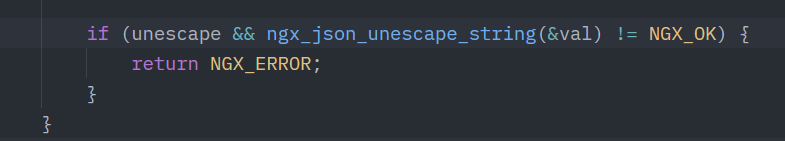
不再对里面的内容解码,此时\u0061就成功绕过了
所以为什么说它是Lazy decode呢
因为假如在配置文件中没有声明json_set $p $request_body "params.role"
params中的role键就会不断的触发NGX_JSON_SKIP事件而受到抑制,因为主键params不存在更多的子节点了,只能跳过不进行解码
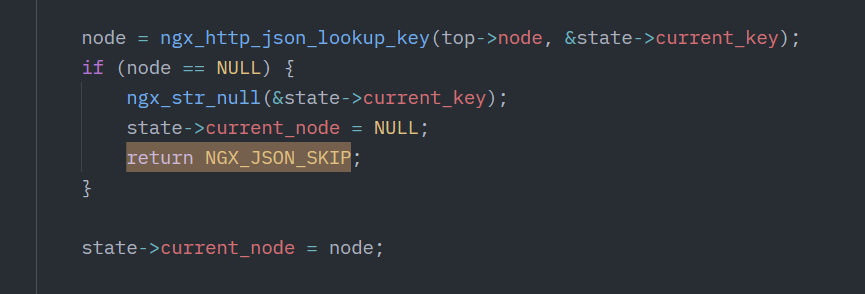
让AI搓了个简陋的流程图方便理解
With the config of “params”
KEY "params"          → handler: lookup_key 命中 → current_node = params节点   (module :748-774)
OBJECT_OPEN '{'       → handler: ngx_http_json_push() 压 frame{                 (module :695-725)
                        frame->start = &body[10],   ← 只记指针,不拷贝不解码
                        frame->node  = params节点 }
KEY "method"          → lookup_key(params节点, "method") == NULL
                      → return NGX_JSON_SKIP                                    (module :767-771)
                      → parser: skip_until_depth = 2,进入抑制模式
':' 'get' ','         → 状态机照常逐字节校验,但 emit 全部 early-return,事件不到 handler
KEY "role"            → 同上 SKIP,继续抑制
':' "\u0061dmin"      → 同上(\u0061 的 4 个 hex 位在 ngx_json_escaped_hex 态
                        照常累加校验,然后丢弃)
'}'                   → ngx_json_close() → depth-- → emit OBJECT_CLOSE          (parser :780-795)
OBJECT_CLOSE '}'      → handler: slice.data = frame->start;
                        slice.len  = &body[45] - &body[10] + 1 = 36
                      → store(state, node, &slice, /*unescape=*/0)              (module :731-741)
'}'                   → 根对象关闭,parse 返回 NGX_OK
With the config of “params.role”
OBJECT_OPEN root '{'   → push frame{start=&body[0],  node=root}        (module :698-703)
KEY "params"           → lookup_key(root, "params") 命中中间节点
                       → current_node = params节点                      (:766-773)
OBJECT_OPEN '{'        → push frame{start=&body[10], node=params节点}   (:709-725)
KEY "method"           → lookup_key(params节点, "method") == NULL
                       → NGX_JSON_SKIP → 抑制到成员结束                  (:767-771)
KEY "role"             → lookup_key(params节点, "role") == role节点      ← 翻转点①
                       → current_node = role节点(SKIP 不再发生)
'"' "\u0061dmin" '"'   → 解析器:escaped_hex 态 codepoint 累到 0x61 后丢弃,
                         emit VALUE_STRING, token = body[34..43](10 个原始字节)
VALUE_STRING           → is_member=1 → node = role节点                  (:791-794)
                         node->ndests(=1) > 0 → 进 store:
                           ngx_http_json_store(state, node, &value,
                               event == NGX_JSON_VALUE_STRING)          ← 翻转点②,实参=1
OBJECT_CLOSE params'}' → top->node(params)->ndests == 0
                       → 不进 store,不切片,仅 state->stack.nelts--     ← 翻转点③ (:732-743)
OBJECT_CLOSE root '}'  → parse 返回 NGX_OK
那么是否还有其他的利用呢?
那就要看后端的语言特性了
NFKC in Python
常年出现在SSTI和Jail里面的Python特性
在这里也可以用上,同样是利用python解析,但是Nginx无法进行同样的转义,从而放行恶意请求
比如把admin换成admin,一样可以达到绕过的效果
How to avoid Prase Difference in latest Nginx
其实不难发现
我们前面的攻击手段大部分都建立在黑名单的基础上
即拦截指定的method,而其他的都进行放行
那么如果我们配置白名单,对白名单外的method都进行拦截
这样就不会因为reset返回的not_found导致寻找指定键失败从而进入default分支,而是直接被拦截