PTA题目爬取转接AI的一次尝试
PTA题目爬取转接AI的尝试
依旧造轮椅
上个Python选修课但是要刷的题目好多啊。鬼脑一动看看能不能抓掉包转接给AI让它自动帮我提交答案,只保存不提交,防止出现某些意外
简单喵两句
抓取流程
首先挺惊喜的,登录没有加密逻辑,就是明文登录
POST /api/users/sessions HTTP/1.1
Host: passport.pintia.cn
Connection: keep-alive
Content-Length: 74
sec-ch-ua-platform: "Windows"
Accept-Language: zh-CN
sec-ch-ua: "Chromium";v="154", "Google Chrome";v="154", "Not A(Brand";v="99"
sec-ch-ua-mobile: ?0
X-Lollipop: fe247aa898e49a308f8f302df0145f8c
X-Marshmallow:
User-Agent: Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/154.0.0.0 Safari/537.36
Accept: application/json;charset=UTF-8
Content-Type: application/json;charset=UTF-8
Origin: https://pintia.cn
Sec-Fetch-Site: same-site
Sec-Fetch-Mode: cors
Sec-Fetch-Dest: empty
Referer: https://pintia.cn/
Accept-Encoding: gzip, deflate, br, zstd
Cookie: PTASession=583f97d2-f986-415b-ab90-4425c3b5d504; _ga=GA1.1.841321695.1791381611; _ga_ZHCNP8KECW=GS2.1.s1791381611$o1$g1$t1791381623$j48$l0$h0

{"email":"admin@example.com","password":"admin@114514","rememberMe":true}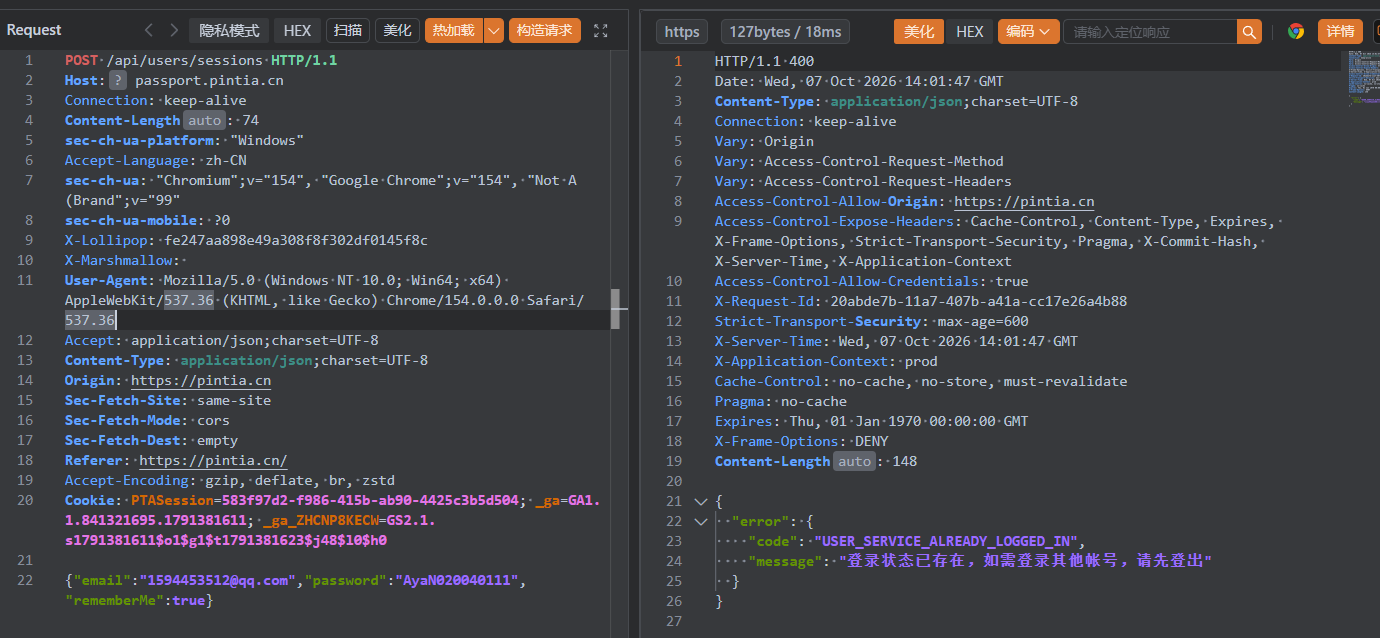
下一个就是抓取题单
GET /api/problem-sets?filter=&limit=7&order_by=END_AT&asc=true HTTP/1.1
Host: pintia.cn
Connection: keep-alive
sec-ch-ua-platform: "Windows"
Accept-Language: zh-CN
sec-ch-ua: "Chromium";v="154", "Google Chrome";v="154", "Not A(Brand";v="99"
sec-ch-ua-mobile: ?0
X-Lollipop: fe247aa898e49a308f8f302df0145f8c
X-Marshmallow:
User-Agent: Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/154.0.0.0 Safari/537.36
Accept: application/json;charset=UTF-8
Content-Type: application/json;charset=UTF-8
Sec-Fetch-Site: same-origin
Sec-Fetch-Mode: cors
Sec-Fetch-Dest: empty
Referer: https://pintia.cn/problem-sets/dashboard
Accept-Encoding: gzip, deflate, br, zstd
Cookie: PTASession=583f97d2-f986-415b-ab90-4425c3b5d504; _bl_uid=v4mXUuO9yO76Cmcztiz4apnlddm0; _ga=GA1.1.841321695.1791381611; JSESSIONID=FE077B46A5ED7D1658902616F73CE309; _ga_ZHCNP8KECW=GS2.1.s1791381611$o1$g1$t1791382355$j53$l0$h0
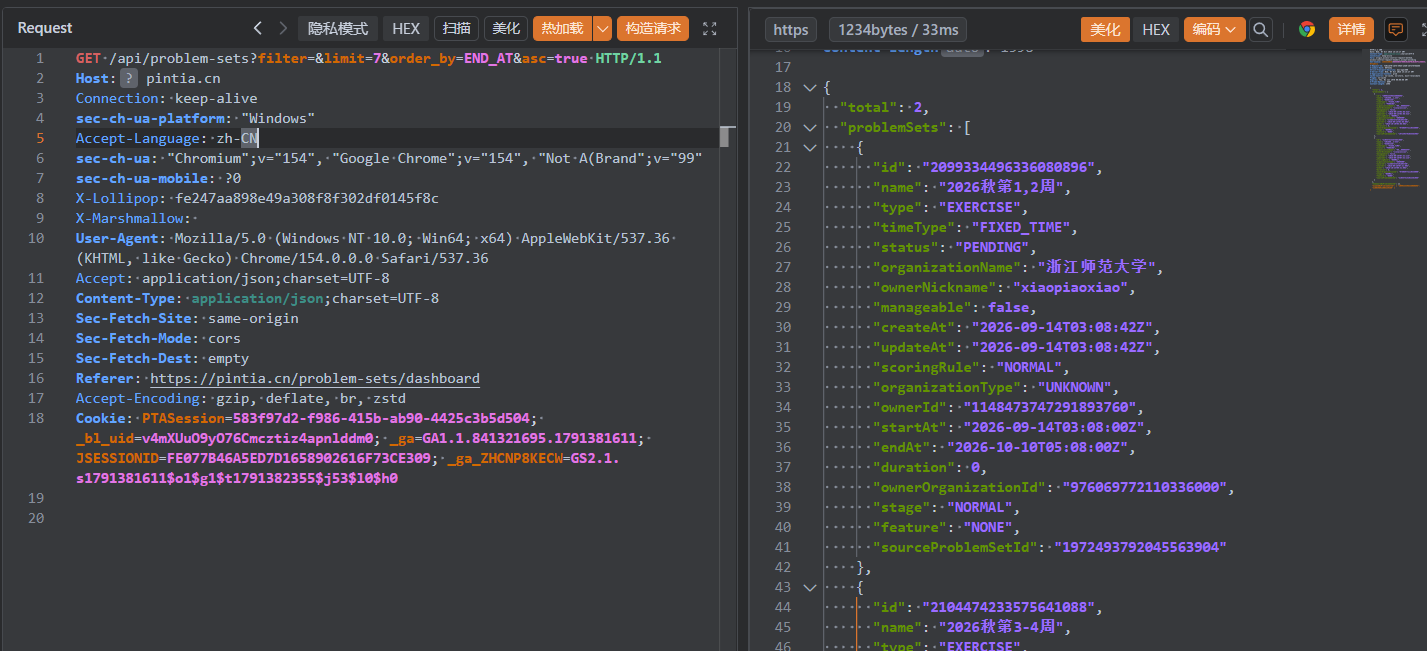
这里select到id就可以,给下一步爬题目奠基来的
接着发个这样的包就行
GET /api/problem-sets/[id]/exams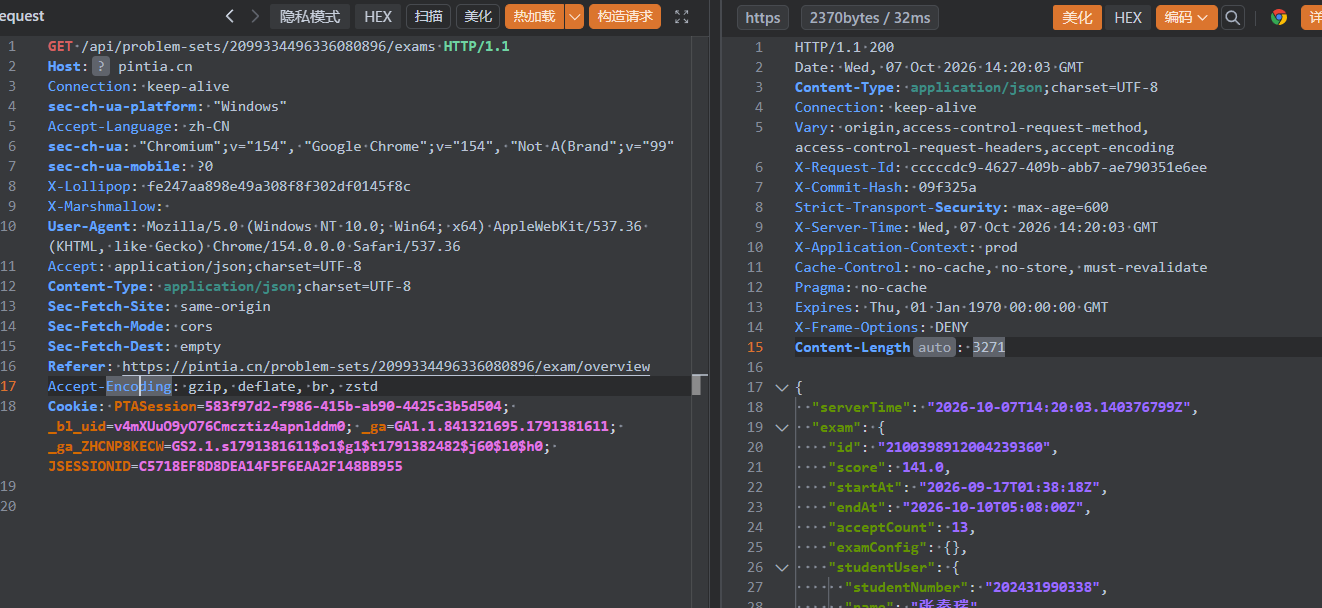
探测一下是不是存在其实没啥实质性作用,并且取exam的id
虽然后来证明没什么用(,它那个包好像不用examid的参数也能正常取到
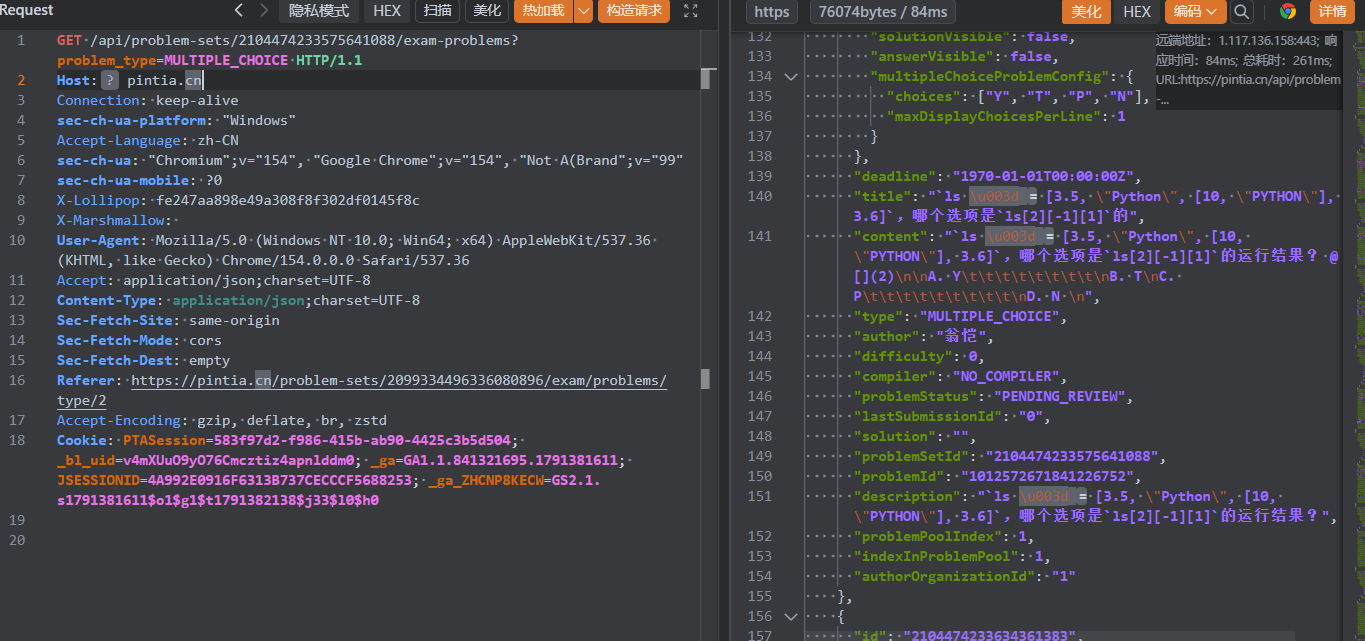
但是问题出现了,它的题型是不确定的,手动去返回包里遍历收集又太慢了,我们直接预定义一个set存放就行
接着
/api/problem-sets/[id]/exam-problems?problem_type=[type]遍历测试一下就好了
提交也很简单
POST /api/exams/2100398912004239360/exam-submissions HTTP/1.1
Host: pintia.cn
Connection: keep-alive
Content-Length: 375
sec-ch-ua-platform: "Windows"
Accept-Language: zh-CN
sec-ch-ua: "Chromium";v="154", "Google Chrome";v="154", "Not A(Brand";v="99"
sec-ch-ua-mobile: ?0
X-Lollipop: fe247aa898e49a308f8f302df0145f8c
X-Marshmallow:
User-Agent: Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/154.0.0.0 Safari/537.36
Accept: application/json;charset=UTF-8
Content-Type: application/json;charset=UTF-8
Origin: https://pintia.cn
Sec-Fetch-Site: same-origin
Sec-Fetch-Mode: cors
Sec-Fetch-Dest: empty
Referer: https://pintia.cn/problem-sets/2099334496336080896/exam/problems/type/2
Accept-Encoding: gzip, deflate, br, zstd
Cookie: PTASession=583f97d2-f986-415b-ab90-4425c3b5d504; _bl_uid=v4mXUuO9yO76Cmcztiz4apnlddm0; _ga=GA1.1.841321695.1791381611; _ga_ZHCNP8KECW=GS2.1.s1791381611$o1$g1$t1791383074$j60$l0$h0; JSESSIONID=5AC75FF31F105E254638B99CB267BC2B

{"problemType":"MULTIPLE_CHOICE","details":[{"problemId":"0","problemSetProblemId":"2099334496411578418","multipleChoiceSubmissionDetail":{"answer":"C"}},{"problemId":"0","problemSetProblemId":"2099334496411578419","multipleChoiceSubmissionDetail":{"answer":"B"}},{"problemId":"0","problemSetProblemId":"2099334496411578422","multipleChoiceSubmissionDetail":{"answer":"C"}}]}
本质就是题型+一个题目答案的列表
至此包就已经扒完了,那么要怎么喂给ai呢?直接写成skill给AI?好像也有点慢啊
写成MCP server怎么样?好像是一个很好的想法
既不通过AI去请求浪费不必要浪费的token,又能很好的把整套逻辑包进去
大概就是
AI client ===================MCP Server ===========================Platform
		request the tool
        -------------------->			login and get the content
        							  ------------------------->
        <--------------------
        response the problems
           with their id

         request the tool and
           send answers					   submit the answers
        -------------------->           --------------------------->
访问平台API从响应里面提取题目信息啊,一般的作业平台都是一次能直接看到所有这个类型的题目,这样mcp server处理后就能整合成一个大的list,response给client端之后AI就可以一次直接解答所有类型的所有题目,接着再把答案发送给mcp server让其提交所有的答案本来想着应该会很顺利,但是不出意外的触发检测了

又要auto绕图形验证码了有感觉吗
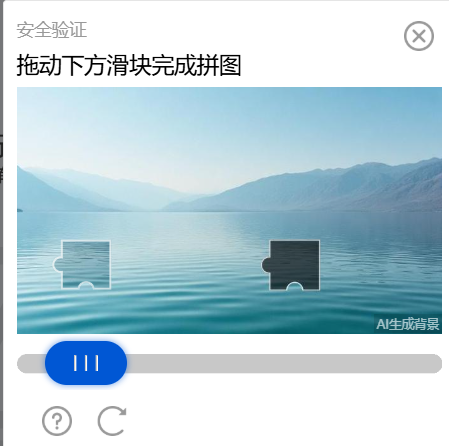
不知道哪家的,收集下信息看看有没有自动过验证码的脚本
确认产品,找了一下发现相关的自动破解还是很多的
但是想想还是自己调一下这个过程
TX滑块Captcha绕过
抓了个纯净点的包
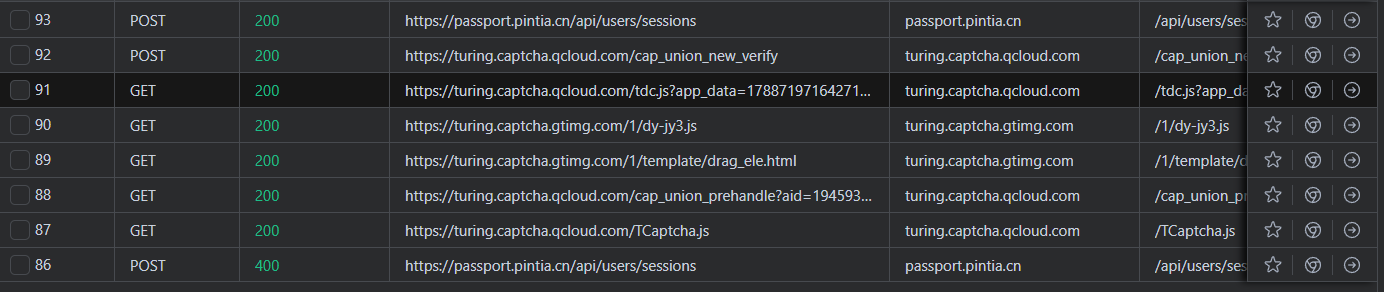
要关注的就是中间这几个
先不看加载的那几个静态
GET /cap_union_prehandle?aid=194593025&protocol=https&accver=1&showtype=popup&ua=TW96aWxsYS81LjAgKFdpbmRvd3MgTlQgMTAuMDsgV2luNjQ7IHg2NCkgQXBwbGVXZWJLaXQvNTM3LjM2IChLSFRNTCwgbGlrZSBHZWNrbykgQ2hyb21lLzE1NC4wLjAuMCBTYWZhcmkvNTM3LjM2&noheader=1&fb=1&aged=0&enableAged=0&enableDarkMode=0&grayscale=1&clientype=2&cap_cd=&uid=&lang=zh-cn&entry_url=https%3A%2F%2Fpintia.cn%2Fauth%2Flogin&elder_captcha=0&js=%2Ftcaptcha-frame.ba387dd1.js&login_appid=&wb=2&tkid=581051966&subsid=1&callback=_aq_793505&sess=
Host: turing.captcha.qcloud.com
Connection: keep-alive
sec-ch-ua-platform: "Windows"
User-Agent: Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/154.0.0.0 Safari/537.36
sec-ch-ua: "Chromium";v="154", "Google Chrome";v="154", "Not A(Brand";v="99"
sec-ch-ua-mobile: ?0
Accept: */*
Sec-Fetch-Site: cross-site
Sec-Fetch-Mode: no-cors
Sec-Fetch-Dest: script
Sec-Fetch-Storage-Access: active
Referer: https://pintia.cn/
Accept-Encoding: gzip, deflate, br, zstd
Accept-Language: zh-CN,zh;q=0.9
返回的报文是
200 OK
Date: Thu, 08 Oct 2026 07:29:19 GMT
Content-Type: text/javascript;charset=utf-8
Connection: keep-alive
P3P: CP=CAO PSA OUR
Pragma: No-cache
Server: Trpc httpd
Server: tencent http server
Content-Length: 3123
_aq_793505({
state: 1,
ticket: '',
capclass: '1',
subcapclass: '2401',
src_1: 'cap_union_new_show',
src_2: 'template/new_placeholder.html',
src_3: 'template/new_slide_placeholder.html',
sess: 's0aVNnVEjY5oUozi4rpJVPR7-RFxNY6v0BOq00Y767YDbKsExq37-Zzl6EADCEvHN2GwMBxCK7b5YSn5JKtrM4DYDXycFK4jhU5I8S8IR2JcG02MsiidQzMbth0eW3No1o5S0mq_tI0aMfYfZj62dn2aESs13k7jLlP7skhYa3-jrWxiFIqGpV3BXXYksCojrw-PDHN1UB4-RhIk7Fm97oznDGUn0p0h7LWUr0a4h8RyBDPtcB5nVWBm90EKK6yJDH2217-2hZOcEJgadt9aGbgDxcVHCcUpO5ktuulTOxj7QAfRcgyjAw7ywloUyY8zyRTvw55cg6gTAsj8BYI43DJ2Rhr_7sT46ySsVqPROMSaAMwnFVBU9-7LAD_E5O2PSSYvoVwQu5tpweW9OF6BoXtOIMwiRWhTf8',
randstr: '',
sid: '1788719716427149312',
log_js: '',
data: {
comm_captcha_cfg: {
tdc_path: '/tdc.js?app_data=1788719716427149312&t=619891543',
feedback_url: 'https://support.qq.com/products/304457',
pow_cfg: {
prefix: 'a594cb9f0137effe#',
md5: 'db933e29a68df4fca17a564763c649ba',
},
},
dyn_show_info: {
lang: 'zh-cn',
instruction: '拖动下方滑块完成拼图',
bg_elem_cfg: {
sprite_pos: [0, 0],
size_2d: [672, 480],
img_url:
'/cap_union_new_getcapbysig?img_index=1&image=026109000000003500000015a28ce71427b0&sess=s0CjkHrSgjdWiWT5RoW4sPl5Kne4TgDGGsPr58cFYe3u1gyiEPr4uEra81fxCn5t4lXeK6hhIJ1YsLzkCkD_ET-U36qkSn6rNo2TxLXPxeLNPyfquU5rv2fQtrLYjiZGDaU18yk7SSFBXhG52yNhucWjQodPpqgoEwguSFG6op4AQgmy12QeYqdR4HAzrLNZtvzbsr_eoLxNQMhdH3rS4bUAsE81CWFVxyqIwefM5ElKYhZ2Y9xghA-mLRf_cdALnjZKA2Tdz2yNKeSHBC49NVIZjeEHr3bFJpJZd2gj-WkQuJA18Kj4orhsz7kl2CsU1kNKu-enh6CY7CPER057xuZqQHjaW4g0-v5uOeLlSU6fRBZW5JLEH-i0oYOu6tg7Iv_QChVBww-JDVbZVtEkzUtZcMiJGvjavP',
},
fg_elem_list: [
{ id: 3, sprite_pos: [0, 422], size_2d: [672, 32], init_pos: [0, 422] },
{
id: 1,
sprite_pos: [140, 490],
size_2d: [120, 120],
init_pos: [50, 63],
move_cfg: {
track_limit: 'x>=50&&x<=552',
move_factor: [1, 0],
data_type: ['DynAnswerType_POS'],
},
},
{
id: 2,
sprite_pos: [0, 490],
size_2d: [130, 70],
init_pos: [45, 402],
move_cfg: { track_limit: 'x>=50&&x<=552', move_factor: [1, 0] },
type: 'slider',
},
],
fg_binding_list: [
{ master: 1, slave: 2, bind_type: 'DynBindType_DX_DX', bind_factor: 1 },
{ master: 2, slave: 1, bind_type: 'DynBindType_DX_DX', bind_factor: 1 },
],
sprite_url:
'/cap_union_new_getcapbysig?img_index=0&image=026109000000003500000015a28ce71427b0&sess=s0CjkHrSgjdWiWT5RoW4sPl5Kne4TgDGGsPr58cFYe3u1gyiEPr4uEra81fxCn5t4lXeK6hhIJ1YsLzkCkD_ET-U36qkSn6rNo2TxLXPxeLNPyfquU5rv2fQtrLYjiZGDaU18yk7SSFBXhG52yNhucWjQodPpqgoEwguSFG6op4AQgmy12QeYqdR4HAzrLNZtvzbsr_eoLxNQMhdH3rS4bUAsE81CWFVxyqIwefM5ElKYhZ2Y9xghA-mLRf_cdALnjZKA2Tdz2yNKeSHBC49NVIZjeEHr3bFJpJZd2gj-WkQuJA18Kj4orhsz7kl2CsU1kNKu-enh6CY7CPER057xuZqQHjaW4g0-v5uOeLlSU6fRBZW5JLEH-i0oYOu6tg7Iv_QChVBww-JDVbZVtEkzUtZcMiJGvjavP',
color_scheme: '#0057d4',
},
},
uip: '36.25.1.141',
});
接着就是拿sess
POST /cap_union_new_verify
Host: turing.captcha.qcloud.com
Connection: keep-alive
Content-Length: 2727
sec-ch-ua-platform: "Windows"
User-Agent: Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/154.0.0.0 Safari/537.36
Accept: application/json, text/javascript, */*; q=0.01
sec-ch-ua: "Chromium";v="154", "Google Chrome";v="154", "Not A(Brand";v="99"
Content-Type: application/x-www-form-urlencoded; charset=UTF-8
sec-ch-ua-mobile: ?0
Origin: https://turing.captcha.gtimg.com
Sec-Fetch-Site: cross-site
Sec-Fetch-Mode: cors
Sec-Fetch-Dest: empty
Referer: https://turing.captcha.gtimg.com/
Accept-Encoding: gzip, deflate, br, zstd
Accept-Language: zh-CN,zh;q=0.9
collect=386NxiV8EKm8YUv94gxyd7xhS%2F3iDHJ3L5kjgBfmtdxMGD%2BVL4dMAwETVWTQMpU1KknUbSXBCWPJwD4gjwaSEFE3kUzyilz3XN7kH7EEnWQ4KDOtRekbwljQ7ca....2FZwghrwWZ720RcPZw7A%3D&sess=s0aVNnVEjY5oUozi4rpJVPR7-RFxNY6v0BOq00Y767YDbKsExq37-Zzl6EADCEvHN2GwMBxCK7b5YSn5JKtrM4DYDXycFK4jhU5I8S8IR2JcG02MsiidQzM...Asj8BYI43DJ2Rhr_7sT46ySsVqPROMSaAMwnFVBU9-7LAD_E5O2PSSYvoVwQu5tpweW9OF6BoXtOIMwiRWhTf8&ans=%5B%7B%22elem_id%22%3A1%2C%22type%22%3A%22DynAnswerType_POS%22%2C%22data%22%3A%22393%2C63%22%7D%5D&tkid=581051966&pow_answer=a594cb9f0137effe%23861&pow_calc_time=19response
200 OK
Date: Thu, 08 Oct 2026 07:29:25 GMT
Content-Type: application/json
Connection: keep-alive
P3P: CP=CAO PSA OUR
Pragma: No-cache
Server: Trpc httpd
Server: tencent http server
Accept-Ranges: bytes
access-control-allow-origin: *
Content-Length: 243
{
"errorCode": "0",
"randstr": "@eAi",
"ticket": "tr03kNgzAV....L6UilK2-",
"traceId": "",
"errMessage": "",
"sess": ""
}
拿到了ticket和randstr就可以美美登录成功了
问题就是这里怎么拿了,有两种思路
一种就是前面登录的过程全部替换成selenium模拟登录,拿到seesion后一键继承,这种应该比较简单了,但是会慢很多
另一种就是纯走HTTP,通过load到的包来直接用opencv过验证
这里我们用后面一种,直接让AI搓一下就行(
成功进入首页
突然发现自己少看一个包(本来我还纳闷为什么看来看去没有给总的题目类型的)
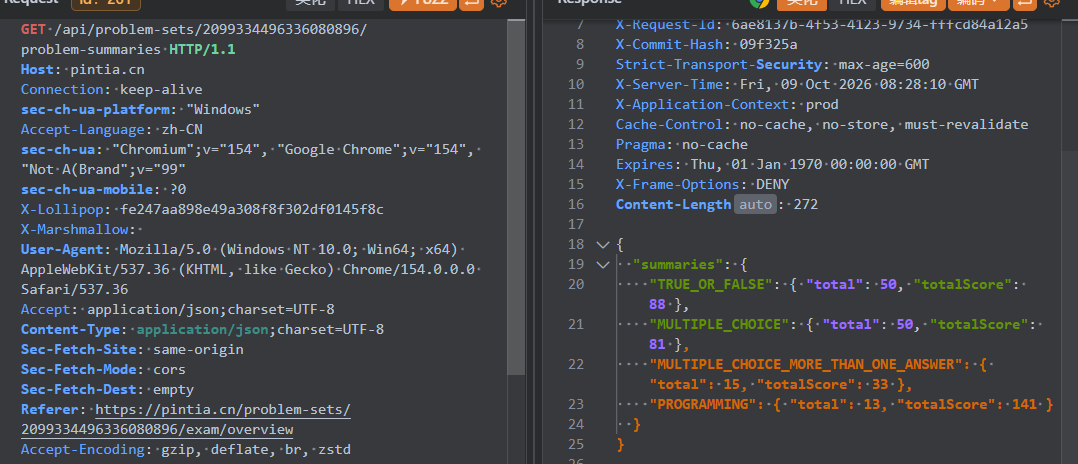
这样也不用猜题目类型了(
然后我们需要return给AI的是probelmType,problemSetProblemId,content
那么就查询题目类型接着提取json["problemSetProblems"]
存下来的是一个列表,接着提取每个元素的id和content就大功造成了
AI需要返回给我们的是probelmType,problemSetProblemId,answer
但是这里太频繁的测试导致我的ip被腾子的大手限流了,那么就需要把Cookie持久化到本地进行复用了,那么怎么办呢?
巧了,这里我刚好在抓包测试能不能看到测试的完成数据,发现三天的session居然还能使用,我要绷不住了,那么就说明它这个session的签发时间足够长,大可以保存到本地,这对我们后面把不同模块封装成tools也有好处,防止频繁访问导致MCP的交互流出现问题
然后我们看看提交的包,所有题目提交的接口都是一样的
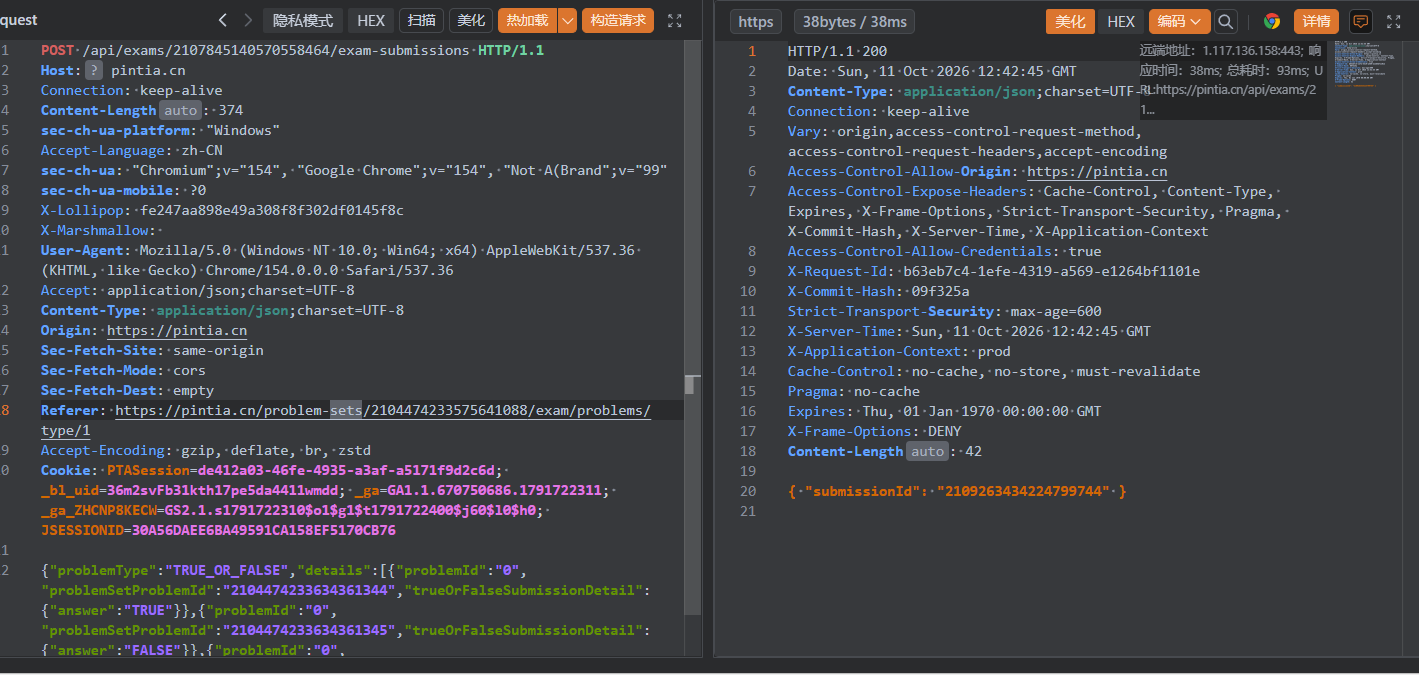
判断题:
{"problemType":"TRUE_OR_FALSE","details":[{"problemId":"0","problemSetProblemId":"2104474233634361344","trueOrFalseSubmissionDetail":{"answer":"TRUE"}},{"problemId":"0","problemSetProblemId":"2104474233634361345","trueOrFalseSubmissionDetail":{"answer":"FALSE"}},{"problemId":"0","problemSetProblemId":"2104474233634361346","trueOrFalseSubmissionDetail":{"answer":"FALSE"}}]}单选题:
{"problemType":"MULTIPLE_CHOICE","details":[{"problemId":"0","problemSetProblemId":"2104474233634361382","multipleChoiceSubmissionDetail":{"answer":"B"}},{"problemId":"0","problemSetProblemId":"2104474233634361383","multipleChoiceSubmissionDetail":{"answer":"C"}}]}编程题
{"problemType":"PROGRAMMING","details":[{"problemId":"0","problemSetProblemId":"2104474233634361469","programmingSubmissionDetail":{"program":"nums = eval(input())\nrepeat = sorted({x for x in nums if nums.count(x) > 1})\nprint(*repeat, end=' ')","compiler":"PYTHON3"}}]}但是这里我们要测试一下编程题是不是支持批量提交的
这里我又抓了另一道题目的包
{"problemType":"PROGRAMMING","details":[{"problemId":"0","problemSetProblemId":"2104474233634361456","programmingSubmissionDetail":{"program":"s = input().strip()\nprint(\"YES\" if int(s[-1]) % 2 == 1 else \"NO\")","compiler":"PYTHON3"}}]}接着合并一下
{"problemType":"PROGRAMMING","details":[{"problemId":"0","problemSetProblemId":"2104474233634361469","programmingSubmissionDetail":{"program":"nums = eval(input())\nrepeat = sorted({x for x in nums if nums.count(x) > 1})\nprint(*repeat, end=' ')","compiler":"PYTHON3"}},{"problemId":"0","problemSetProblemId":"2104474233634361456","programmingSubmissionDetail":{"program":"s = input().strip()\nprint(\"YES\" if int(s[-1]) % 2 == 1 else \"NO\")","compiler":"PYTHON3"}}]}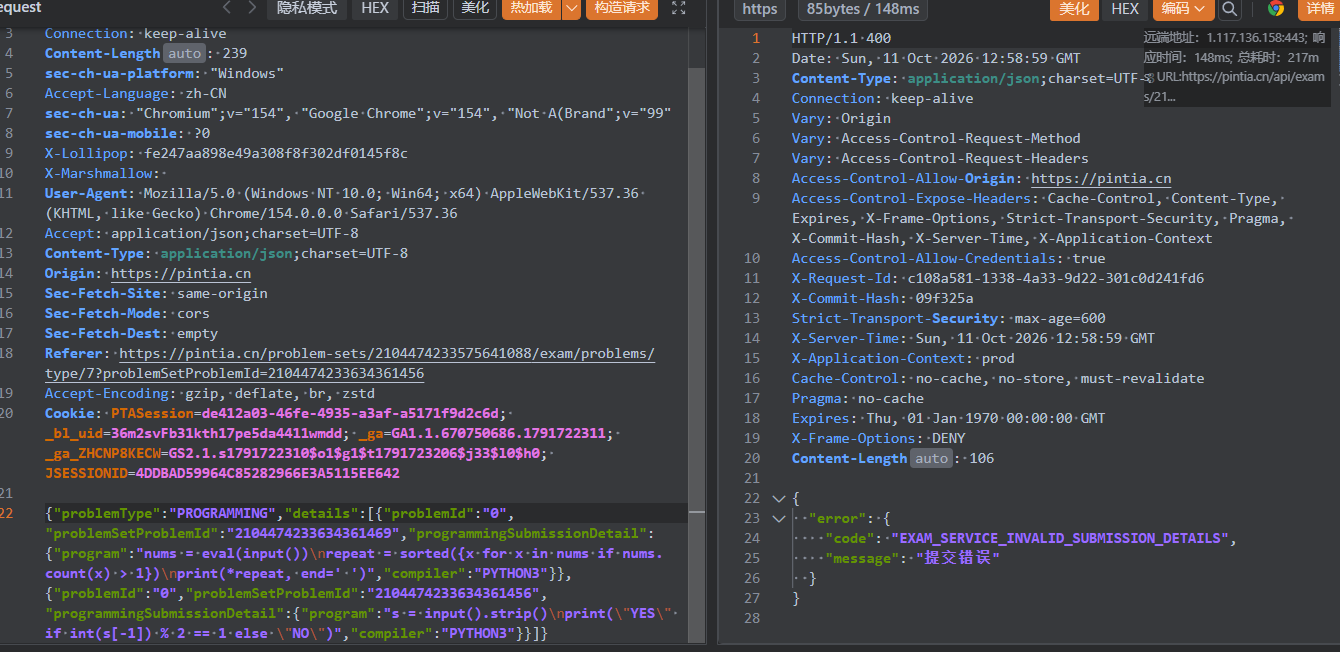
失败了
那么submit就只能拆成两个来做了
封装成tool
初步想的是设计成两个tool
一个负责爬取,一个负责提交
但是后来发现两个都需要获取session才能继续操作,那么就把申请session单独分离出来成一个tool然后持久到本地
那么大致就是
- pta_login:登录平台获取session实现对话持久化
- pta_list_exams:通过指定接口拉取当前正在进行的练习,并根据用户的需求确定要做哪份练习
- pull_exam_set:批量拉取指定练习的所有题目,并剥离只剩下需要的字段
- submit_answers:批量提交客观题,主观题(比如编程题目)接口上只支持单个提交
- pta_submission_detail:查看提交的结果(这里是针对编程题的提交结果做的特化)
比较大的问题就是:如何处理大量的题面以及编程题的提交?
初步想法是
最好是把题面再做一下处理,筛掉无意义的字符,比如大量的连续\n,如果直接传输过去,会很占上下文
再和ai博弈了一下,发现可以调用sampling功能直接和LLM交互
但是实际也差不了多少,题面的那些工作量上减不下来的,最多写一个filter给文本做一些基础的清洗
接着AI的答案也要save到本地去,从而减少token的消耗(只要就是要指定格式这一块)
本来想用AI在这个基础上直接写server的,写完发现还不如自己来,代码质量实在是差到令人发指。无意义的调用和函数编写一堆
手搓tool
中间也发现了很多问题,记录一下
爬取时的filter
就是最开始获取exam时候的filter,filter为空的时候他会打印所有考试,而页面一般加载时会自动载入某个时间节点做筛选
比如这样
GET /api/problem-sets?filter=%7B%22endAtAfter%22%3A%222026-10-12T16%3A00%3A00.000Z%22%7D&limit=7&order_by=END_AT&asc=true这里解码完是{"endAtAfter":"2026-10-12T16:00:00.000Z"}
那么我们仿造一下在开局就做好筛选就能拿到纯净的alive exam_id
查了下这个是utc的时间标准,也就是说我们查询的时候不是用北京时间的(,那么参数就要控制一下了,最后再做编码
time_point=datetime.now(timezone.utc).strftime('%Y-%m-%dT%H:%M:%S.000Z')
template='{"endAtAfter":"'+time_point+'"}'
print(quote(template))
怎么处理答案
最好就是存储到本地,接着调用submit_answer的时候直接从本地读取,然后自己纠正提交的json格式
从而来减少token的消耗,拿dsf举例吧,如果让它把格式修正好,一般它就要构思脚本去规范格式,这样就会占用一些context,那还不如规范出最简的格式
然后在tool内部自己调整格式
belike:
{"problemType":"MULTIPLE_CHOICE","details":[{"problemSetProblemId":"2099334496411578418","answer":"C"},{"problemSetProblemId":"2099334496411578419","answer":"B"}]}而我们要提交的格式是
{"problemType":"MULTIPLE_CHOICE","details":[{"problemId":"0","problemSetProblemId":"2104474233634361382","multipleChoiceSubmissionDetail":{"answer":"B"}},{"problemId":"0","problemSetProblemId":"2104474233634361383","multipleChoiceSubmissionDetail":{"answer":"C"}}]}这种程度其实脚本调整起来还是非常方便的
TODO
其实还有一些事情没有做的
第一个就是OCR,因为在测试中发现有些题目的代码是写在图片里面的,就很难绷
第二个就是FILTER,虽说前面已经节省了一些token的消耗,但是本着不多浪费一点无用的米,感觉还是有必要写个filter去对题目的内容去做一些清洗
项目已上传github欢迎提出意见呢